解读《Nature Plants》2021 年研究——111 种高山植物告诉我们:决定一种花被研究多少的,不是它有多稀有,而是它有多好看。
原文|Adamo et al., Nature Plants 2021, 7, 574–578
色彩鲜艳的花朵,总是最先抓住人的目光。
翻开手机相册,找出你今年拍的花。是不是蓝紫色的、大朵的、开得热热闹闹的占了绝大多数?至于那些灰扑扑的禾本科、绿漆漆的小花,大概连一张都捞不着。我们多少都有点“挑好看的花拍”。
那么,专门研究植物的人呢?那些本该把好奇心平均分配给每一种植物的人,会不会也在不知不觉中,只盯着好看的那些?
这个问题听起来像玩笑,但要正面回答它,需要一套很硬核的方法。2021 年,一支意大利研究团队在《Nature Plants》上把它做成了可以量化的结论。
一、一个玩笑式问题怎么被写成论文
“魅力偏见”在生物学界不算新闻。动物那边早被吐槽过:恐龙、大熊猫、老虎、牛马猪羊的论文汗牛充栋,与它们同域分布的小型无脊椎动物(如很憋屈的老鳖)却几乎无人问津。植物这边其实也一样,只是更难证明——因为“好看”这件事,似乎总能被“研究价值高”这样的理由体面地掩盖过去。
要证明它,得先让“好看”变得可以测量。研究团队挑了意大利与法国交界的滨海阿尔卑斯(Maritime Alps)——西南阿尔卑斯的一部分,也是地中海地区最大的生物多样性热点之一。这里的植物区系被翻查了两百多年,物种名录已经相当完整,几乎没有“还没被发现”的物种能混进来。
他们从最新名录里列出 113 种植物,其中 111 种进入了统计分析。为每一种植物收集了 16 个标准化性状,分成三组:
•形态:花色、花朵直径、株高、花期长度;
•生态:光照、温度、湿度、大陆性、土壤反应、腐殖质、质地与养分(依 Landolt 指示值做主成分分析),以及海拔范围;
•稀有性:分布面积与分布离散度、IUCN 濒危等级、同属物种数量。
“被研究的程度”则用 Web of Science 里 1975 至 2020 年间题录中出现该物种的论文数量衡量,一共 280 篇。引用次数、h 指数这些指标其实和论文数量高度重合,所以只数论文数就够了。这一数下来,进入分析的 111 种里,有 43 种一篇论文都没有,将近四成!
模型上还有一道必须处理的问题。同一个科里的植物常常长得像:亲缘近,长相和习性就相近,连受关注的程度也容易一起高、一起低。换句话说,111 个物种,要是把它们当成毫无关系的个体来算,“同科相似”就会混进结果。为此,研究者把“科”设为模型里的一个分类层次(统计上叫随机效应),让同科之间的相似先被单独算走,剩下的才算作性状本身的贡献。又因为要预测的是“论文有几篇”这样的整数,模型用了专门描述计数的泊松分布。
顺带说一句:这项研究是作者们在意大利疫情封城、实验室和野外工作全部停摆期间,“用来打发时间”做出来的。
二、决定命运的,是“好不好看”
要看清到底是哪一组性状在起作用,研究者用了一种叫方差分解的办法:先把形态、生态、稀有性三组性状分别建模,再两两、三三地组合建模,比较“多放一组进去,能多解释多少”。多出来的那部分,就算这一组自己的功劳(术语叫“独有贡献”)。
拆下来的结果干脆得有点刺眼:形态学一组的独有贡献是 0.149(约 15%),而生态学和稀有性各自的独有贡献都近似于 0。换句话说,一旦知道这朵花长什么样,它的生态位和稀有程度几乎不再提供额外信息。
更硬的证据来自模型筛选。研究者先把 16 个性状全部放进模型,然后一个一个往外删。删得对不对,只看一个分数:性状越有用、模型预测得越准,分数就越低;塞进去的没用性状越多,分数反而被拉高。如此反复,最终留下的只有四项:花色、花朵直径、株高、分布范围。花期长度、海拔高低、同属物种数量等,全都在这一步被剔除。
那么形态里谁是主角?是颜色。以最不显眼的棕绿色花为基准,模型给出的系数是:
•蓝色 2.28(P = 0.00025)
•白色 1.09(P = 0.046)
•红/粉色 0.96(P = 0.086)
•黄色 0.36(P = 0.54)
蓝花遥遥领先,白花次之,这两项达到统计显著;红粉与黄色则未达显著。那些开着亮黄花的植物,在被研究的行列里并不靠前。
另外三个指标也各有意味:
•株高 0.25(P = 0.009):植株越高,论文越多。作者的解释很实在——长得高不只是显眼,更重要的是调查者不必弯腰趴到地上,就能够到它的花序。
•分布范围 0.20(P = 0.033):分布越广,越容易被更多的研究者碰到,也就越容易被研究。
•花朵直径 −0.20(P = 0.050):花越大,论文反而越少,而且刚好卡在显著线的边缘。
最后这一条最反直觉。作者给了一个解释:在滨海阿尔卑斯,有些植物单朵花很小,却组成了一簇簇极醒目的花序(如 Gymnadenia corneliana、Saxifraga florulenta),比一朵孤零零的大花更抓人——他们称之为“花序效应”。
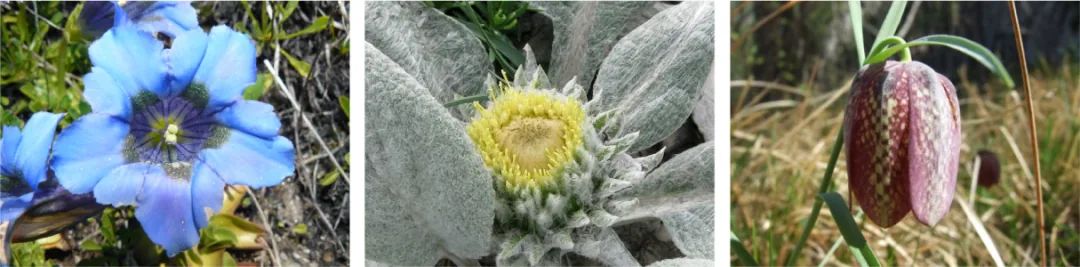
图 1 三种滨海阿尔卑斯植物,三种“被研究的命运”。左:Gentiana ligustica,蓝花、花序醒目,论文很多。中:Berardia lanuginosa,单朵小黄花、短茎,没有论文。右:Fritillaria involucrata,褐色大花、短茎,没有论文。一朵花会不会被研究,往往在颜色、株高与花朵大小这几个特征上就已经分流。引自原论文 Figure 2a。
不过,这四项性状加起来,解释力并不算高。模型还有 75.6% 的方差没能被固定性状解释;按论文 Figure 1b 的分解,这 0.76 里,0.54 可以归因于分类学亲缘关系,也就是这株植物属于哪一个“科”,真正无从解释的只剩 0.22。
怎么理解?大概就是科研惯性。一个课题组做完了某个属的某个种,同一属、同一科的其他种就顺理成章地接着被做:标本好找、文献好查、方法能复用。于是单看数字,“你属于哪个家族”这一项的份量(0.54),比“你长得好看不好看”(0.149)还要大。
这也顺带解释了为什么“稀有性”在模型里毫无贡献:科学家并非不在乎稀有植物,只是他们的选择,主要被另一些更省事、更顺手的东西牵着走。
三、为什么这件事值得在意
如果研究的偏倚只是随机偏移一点,那无关紧要。但偏见会累积:那些被冷落的类群,恰恰可能握着关键的生态信息——土壤固持、传粉网络、群落构建。研究得少,我们对它们的了解就少;了解得少,保护时就更难判断该保什么。
论文把这一现象放进了一个更大的背景。植物长期以来得到的关注和经费都少于动物,学界用“植物盲”(plant blindness)或“植物认知偏差”来形容这种对植物视而不见的状态。而作者想指出的,是植物学界内部更具体的一层偏倚:审美的偏倚。
有意思的是,作者特意回到“审美”这个词的希腊词根——原意是“感官知觉”。人类演化出了三色视觉,能分别分辨蓝、红、绿三个波段;有观点认为,这原本有助于在绿色背景里找到成熟的果实。我们对颜色的敏感,是被生存筛选出来的;而到了科研选题这里,它变成了一个不自觉的偏好。
作者的主张很直接:审美偏见应当被显式地纳入实验设计与物种选择,而不是指望研究者凭自觉去抵消它。把这层偏见摆到明面上,才谈得上更客观的保护决策。
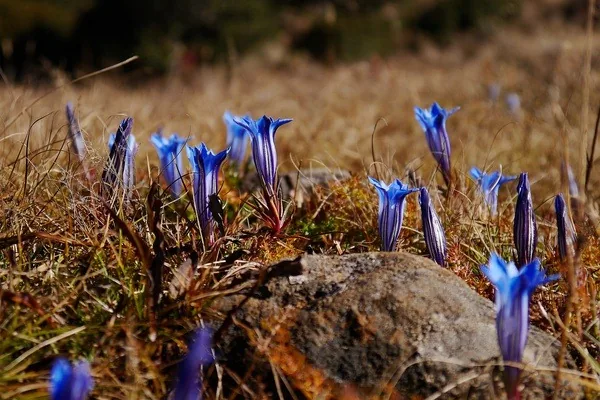
图 2 华丽龙胆(Gentiana sino-ornata,龙胆科龙胆属)。蓝紫色的花在草甸里格外扎眼,也格外容易被镜头和论文同时“选中”——论文里最受青睐的,正是这一类蓝色花。图片取自刷牙的《蓝色精灵:这些年邂逅的蓝色花朵》。
对自然观察者来说,这篇文章最实在的用处,是提醒我们有意识地给“不好看”的类群留位置:
•记录时补上禾本科、莎草科、蓼科这些“绿色小花”——它们常常是草甸与湿地真正的主角;
•花期之外也记营养体,毕竟不开花的植物,占了野外相遇的大多数;
•一份物种清单里如果只有好看的,那它记录的是我们的偏好,而不是这片土地的样貌。
论文最后引了两位生态学家 Kéry 和 Gregg 的一句话:“植物虽然站着不动、等着被数,但它们有时会藏起来。”这话原本说的是野外调查里的“看漏”:植物不会跑,可有些种类生得矮小隐蔽,调查者从旁边走过也未必看得见。作者在这句后面补了半句:“而我们还要说一句——它们常常就藏在最显眼的地方。”
这说的是另一种“藏”:不是长得难找,而是长得不惹眼。它就长在脚边,开得清清楚楚,只是颜色灰绿、花朵细小,目光会自动从它身上滑过去。一种植物能不能被看见,一半取决于它长成什么样子,一半取决于我们想看什么。
花不必为了被人看见才开得好看。但我们可以不必只盯着好看的那些。
原文信息
Adamo M., Chialva M., Calevo J., Bertoni F., Dixon K., Mammola S. Plant scientists’ research attention is skewed towards colourful, conspicuous and broadly distributed flowers. Nature Plants 2021, 7(5), 574–578. DOI: 10.1038/s41477-021-00912-2
数据说明:文中数字与结论均取自该论文的正文、方法、Figure 1、Figure 2 及补充材料。这些结论来自单一山区的案例,推广到其他地区需谨慎。